Microsoft’un Azure MCP Server dokümanında gözden kaçması kolay bir ayrıntı var: Azure Skills Plugin, 26’dan fazla skill’i Azure MCP Server ile birlikte çalışacak şekilde paketliyor. Aynı pakette hem MCP hem skill bulunuyor ve ikisi ayrı işler görüyor. Sahada en sık duyduğum soru da tam buradan çıkıyor: MCP server kurduk, skill’e ne gerek var?
Leon Jose’nin LinkedIn’de paylaştığı gönderi bu katmanları insan vücuduna benzetiyor, akılda kalan bir çerçeve; fakat bir aracı kimin çalıştırdığını ve yetkinin nerede denetlendiğini göstermiyor. Bu yüzden her katmanı gerçek teknik davranışıyla ele alacağım.
Önce LLM’in araç çağrısıyla ilişkisine, ardından RAG, MCP ve skill’in ayrı ayrı neyi çözdüğüne ineceğiz; sonra tek bir Azure isteğinin bu katmanlardan nasıl geçtiğini adım adım izleyip hepsini bir tabloda yan yana koyacağız. LLM, RAG ve agent arasındaki temel ayrımı ayrı bir yazıda anlattığım için o kısmı kısa tutuyorum; ağırlık MCP ile skill farkında.
LLM araç çalıştırmaz, çağrı ister
LLM, metni token’lara bölüp girdi dizisine bakarak sıradaki token’ları üreten bir model. Gördüğü her şey context window içinde duruyor: sistem talimatı, konuşma geçmişi, araç tanımları, getirilen dokümanlar. Pencerenin hem girdi hem çıktı için bir token sınırı var ve aşağıda anlatacağım her katman bu pencereye bir şey ekliyor.
Tool calling, ya da function calling, tam bu noktada devreye giriyor. Uygulama modele araçların adını, açıklamasını ve JSON Schema ile tanımlanmış parametrelerini veriyor. Model bir aracın gerektiğine karar verirse cevap olarak argümanları içeren bir JSON nesnesi döndürüyor. Microsoft’un Foundry function calling dokümanı akışı açıkça tarif ediyor: fonksiyonu uygulama çalıştırır, sonucu modele geri gönderir, model son cevabı bu sonuca göre yazar.
Model hiçbir aracı kendisi çalıştırmaz, yalnızca çağrı isteği üretir. Bu yüzden yetkiyi modelde aramayın; sınırı, aracı çalıştıran katman çizer.
RAG cevabı kendi dokümanınıza bağlar
Model, eğitildiği tarihe kadar gördüğü veriyi bilir. Şirketinizin etiketleme standardından ya da geçen ay güncellenen runbook’tan haberi yoktur. RAG, yani retrieval-augmented generation, bu boşluğu her istekte arama yaparak kapatıyor. Dokümanlar parçalara bölünüp embedding’e çevriliyor, sorgu da aynı şekilde vektöre dönüşüyor ve vektör uzayında en yakın parçalar bulunuyor. Azure AI Search bu aramayı anahtar kelime aramasıyla birleştiren hibrit sorgu ve semantic ranking sunuyor. Agentic retrieval adlı yeni yaklaşımda sorguyu bir LLM planlayıp alt sorgulara bölüyor.
Getirilen parçalar prompt’a ekleniyor, model cevabını onlara dayandırıyor. Modelin ağırlıkları değişmiyor ve kalıcı bir hafıza da oluşmuyor; arama her istekte yeniden yapılıyor. Token sınırı yüzünden retrieval katmanının kısa ve ilgili sonuç döndürmesi gerekiyor. Erişim filtresi de bu katmanda uygulanmalı: kullanıcının göremeyeceği doküman context’e hiç girmemeli.
MCP aracı standart biçimde sunar, işi yapmaz
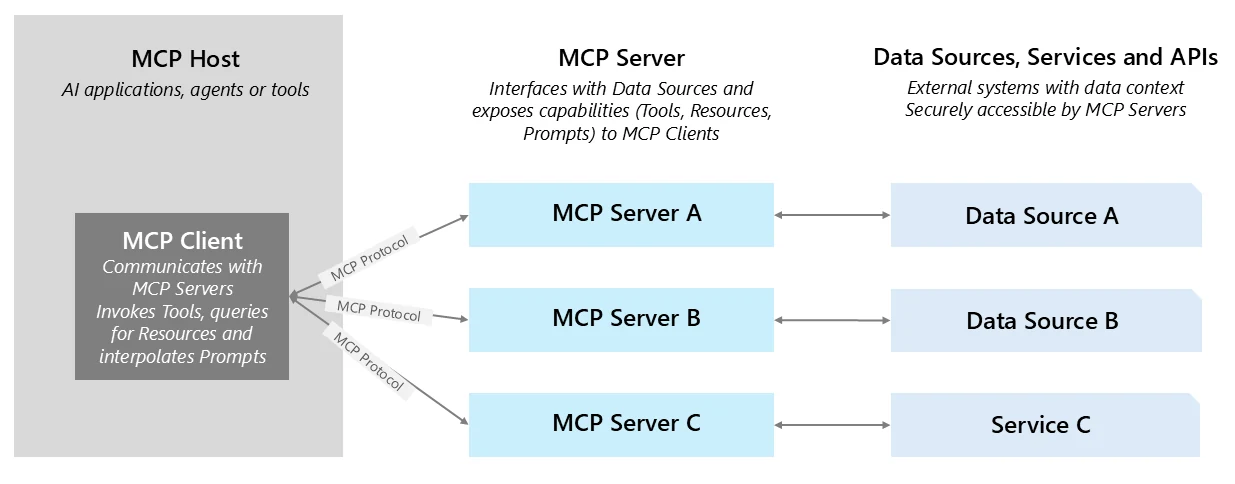
Tool calling modele araç tanımı vermeyi çözüyor. Ancak her uygulama bu tanımları kendi biçiminde yazarsa aynı Azure entegrasyonunu her istemci için yeniden kurmanız gerekir. Model Context Protocol spesifikasyonu bu bağlantıyı standart hale getiriyor. Üç rol var: host, kullanıcının çalıştığı LLM uygulaması; client, host içinde her server için açılan bağlayıcı; server ise yetenek sunan servis. Mesajlar JSON-RPC 2.0 biçiminde gidip geliyor.
Bir server üç tür şey sunabiliyor. Tools modelin çağırabileceği fonksiyonlar, resources bağlam olarak okunacak veri, prompts ise kullanıcının seçebileceği şablon mesajlar. Host araçları tools/list ile keşfediyor, tools/call ile çağırıyor. Taşıma için iki standart yol tanımlı. stdio’da client, server’ı yerel bir alt süreç olarak başlatıp standart girdi ve çıktı üzerinden konuşuyor. Streamable HTTP’de mesajlar tek bir endpoint’e HTTP POST ile gidiyor, yanıt düz JSON ya da SSE akışı olarak dönüyor.
Spec biçiminde sadeleştirilmiş bir tool tanımı şöyle görünür:
|
1 2 3 4 5 6 7 8 9 10 11 12 13 |
{ "name": "group_list", "title": "Kaynak gruplarını listele", "description": "Belirtilen abonelikteki kaynak gruplarını döndürür.", "inputSchema": { "type": "object", "properties": { "subscription": { "type": "string", "description": "Abonelik ID veya adı" } }, "required": ["subscription"] } } |
Bu tanımın içinde iş yapan tek satır yok. Abonelikteki kaynak gruplarını gerçekten listeleyen şey, server’ın arkasındaki Azure API’si ve onu çağıran kimlik. Azure MCP Server kimlik doğrulamasını Entra ID ile yapıyor, araçların neye erişebileceği de o kimliğin Azure RBAC yetkileriyle sınırlı. Spec ayrıca araç çağrısından önce host’un kullanıcıdan onay almasını öneriyor. MCP ile doğrudan API çağrısı arasındaki yetki ve entegrasyon farkını MCP ve API yazısında ayrıntılı anlattım; Azure tarafındaki son değişiklikler için Azure MCP Server 3.0 notlarına bakabilirsiniz.
Skill, ajana işin nasıl yapılacağını anlatır
MCP server bağlıyken ajan Azure’daki kaynaklara ulaşabilir. Ama hangi sırayla hangi aracı çağıracağını, App Service için ayrı bir listeleme aracı olmadığında ne yapacağını bilmez. Skill bu prosedür bilgisini taşıyor. Anthropic’in başlattığı ve agentskills.io altında açık standart haline gelen yapıda skill, içinde en az bir SKILL.md dosyası bulunan bir klasör. Dosyanın başındaki YAML frontmatter’da iki zorunlu alan var: name ve description. Yanına scripts/, references/ ve assets/ klasörleri eklenebiliyor.
Microsoft’un azure-skills reposundaki gerçek bir örneğin frontmatter’ı, description kısaltılmış haliyle:
|
1 2 3 4 5 6 7 8 9 |
--- name: azure-resource-lookup description: "List, find, and show Azure resources across subscriptions or resource groups. ... USE FOR: resource inventory, find resources by tag ... DO NOT USE FOR: deploying/changing resources (use azure-deploy), cost optimization ..." license: MIT metadata: author: Microsoft version: "1.2.3" --- |
İşin kalbi yükleme biçiminde. Anthropic dokümanı bunu progressive disclosure olarak tarif ediyor. Başlangıçta yalnızca name ve description sistem prompt’una giriyor, skill başına yaklaşık 100 token. Model istekle description’ın eşleştiğine karar verirse SKILL.md gövdesi okunuyor. Ek dosyalar ve script’ler ancak gövde onlara yönlendirirse okunuyor; script çalıştığında kodu context’e girmiyor, yalnızca çıktısı giriyor. Onlarca skill kurulu olsa bile context’in şişmemesi buradan geliyor.
Bu skill’in gövdesi ilginç bir şey yapıyor: önce ilgili kaynak türü için özel bir MCP aracı var mı diye bakmayı, yoksa Azure Resource Graph sorgusu üretmeyi söylüyor. Skill hangi aracın ne zaman kullanılacağını anlatıyor, aracın kendisi MCP server’da duruyor. Biri diğerinin yerini tutmadığı için aynı pakette yan yana yer alıyorlar.
GitHub Copilot da aynı standardı destekliyor. GitHub dokümanına göre Copilot CLI, Copilot cloud agent ve VS Code’daki agent mode, projedeki .github/skills, .claude/skills ya da .agents/skills klasörlerinden skill okuyabiliyor; kişisel skill’ler ~/.copilot/skills altında duruyor. Benim yazı otomasyonumda Türkçe redaksiyon kuralları .github/skills/insanca/SKILL.md dosyasında tutuluyor, Azure’a erişim ise ayrı bir MCP server üzerinden geliyor. Claude Code tarafında skill’in CLAUDE.md ve rules dosyalarıyla ilişkisini proje yapısı yazısında ele almıştım.
Agent döngüyü kurar, sınırı da o çizer
Buraya kadar saydıklarımın hiçbiri tek başına ajan sayılmaz. Agent, bu parçaları bir döngüde çalıştıran uygulama katmanı. Hedefi alıyor, plan yapıyor, model bir araç çağrısı isterse onu çalıştırıyor, sonucu context’e geri koyuyor ve model yeterli bilgiye ulaşana kadar bunu tekrarlıyor. Konuşma geçmişi ve oturum hafızası bu katmanda tutuluyor. MCP mimarisinde de konuşmanın tamamını host görüyor, server yalnızca kendisine gönderilen isteği görüyor.
İzinler de burada şekilleniyor. Hangi MCP server’ların bağlanacağı, hangi araçların açık olacağı, hangi çağrının kullanıcı onayı bekleyeceği agent ya da host tarafında belirleniyor. Foundry Agent Service’teki MCP aracı bu yüzden çağrıları gözden geçirip onaylama seçeneği sunuyor.
Bir istek, bütün katmanlar: Azure kaynak raporu
Senaryo şu: VS Code’da Copilot agent mode açık, Azure MCP Server araç listesinde seçili ve azure-resource-lookup skill’i kurulu. İstek de net: üretim aboneliğindeki kaynakların etiket uyumunu gösteren bir rapor hazırla.
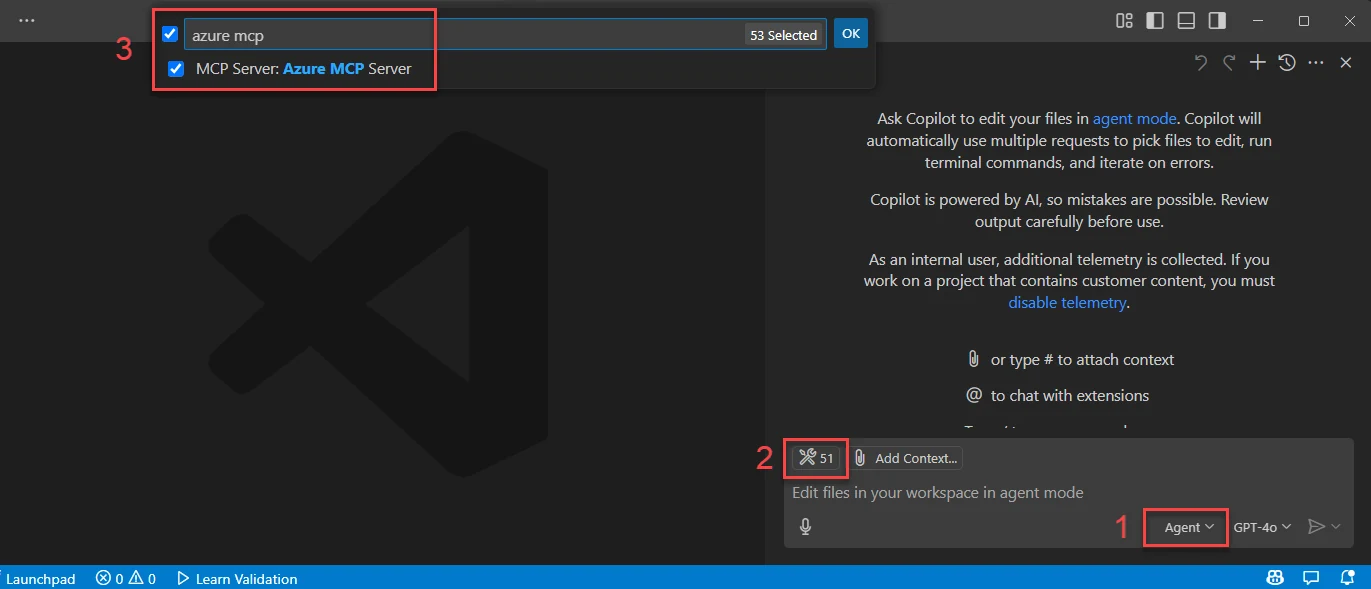
- Agent isteği, sistem talimatını, kurulu skill’lerin name ve description bilgisini ve Azure MCP Server’ın araç listesini context’e koyup modele gönderir.
- Model, kaynak envanteri isteğinin azure-resource-lookup description’ıyla eşleştiğine karar verir; agent SKILL.md gövdesini okuyup context’e ekler.
- Skill’in tarif ettiği sırayla model önce abonelik listesi için bir tool call üretir. Host bu çağrıyı MCP client üzerinden
tools/callolarak Azure MCP Server’a iletir, server Entra ID kimliğiyle Azure’a gidip sonucu döndürür. - Model kaynak grubu listesini ve gerekirse Resource Graph sorgusunu ister. Her çağrı aynı yoldan geçer; kimliğin RBAC yetkisi neye izin veriyorsa o kadarı görünür.
- Raporda şirket içi etiket standardıyla karşılaştırma gerektiği için agent RAG katmanına başvurur. Azure AI Search indeksinden etiketleme standardı dokümanının ilgili parçaları getirilip context’e eklenir.
- Model araç sonuçlarını ve doküman parçalarını birleştirip raporu yazar. Değişiklik yapan bir adım olsaydı host önce kullanıcı onayı isterdi.
Bu akışta LLM karar verip metni üretti, skill prosedürü verdi, MCP Azure’a standart erişim sağladı, RAG şirket bilgisini taşıdı, agent ise hepsini sırayla çalıştırıp sınırları uyguladı. Biri eksik kalırsa iş ya hiç yapılamıyor ya da yanlış sırayla yapılıyor.
Tek tabloda fark
| Kavram | Ne sağlar | Nerede yaşar | Ne zaman kullanılır | Örnek |
|---|---|---|---|---|
| LLM | Token üretir, karar verir, metni yazar | Model servisi | Her istekte | GPT, Claude |
| RAG | Güncel ve şirkete özel bilgiyi context’e taşır | Arama indeksi | Model kurum bilgisini bilmediğinde | Azure AI Search |
| Tool calling | Modelin JSON şemalı çağrı isteği üretmesi | Model API’si ve uygulama kodu | Tek uygulamaya özel araçlarda | Foundry function calling |
| MCP | Dış sistemleri standart protokolle sunar | Ayrı bir server süreci veya uzak endpoint | Aynı entegrasyon birden çok istemcide kullanılacaksa | Azure MCP Server |
| Skill | Prosedür, talimat ve script paketi | Klasördeki SKILL.md dosyası | Ajan erişimi olduğu halde işi doğru sırayla yapamıyorsa | azure-resource-lookup |
| Agent | Döngü, hafıza, izin ve onay | Host uygulama | Çok adımlı, araç gerektiren işlerde | Copilot agent mode, Foundry Agent Service |
Microsoft tarafında bu katmanların hangi ürünlerde karşılık bulduğunu merak ediyorsanız Microsoft AI ekosistemi haritasında toplamıştım.
Hangi katmana ne zaman uzanmalı?
- Model güncel ya da şirkete özel bilgiyi bilmiyorsa RAG ekleyin.
- Ajanın dış bir sisteme erişmesi gerekiyorsa o sistem için bir MCP server bağlayın.
- Ajan erişimi olduğu halde işi eksik ya da yanlış sırayla yapıyorsa prosedürü bir skill dosyasına yazın.
- Yetki ve onay kurallarını modele bırakmayın; host, agent ve RBAC katmanında tanımlayın.
Skill ajana işi nasıl yapacağını, MCP neye erişeceğini söyler; ikisini aynı işte buluşturan şey agent döngüsüdür. Sorularınız olursa yorumlarda buluşalım.