GitHub, 28 Ekim 2026’da GitHub Copilot Fusion’ı genel kullanıma açtı. Model picker’da artık Fusion Standard, Fusion High ve Fusion Max effort seçenekleri var. Yanlış effort alışkanlığı ekibinizin AI Credits tüketimini sessizce büyütebilir, özellikle Copilot’u geniş bir geliştirici grubuna dağıttıysanız yeni seçeneği açmadan önce hangi modellerin kullanılabildiğine bakmak gerekiyor.
Bu yazıda Fusion’ın göreve göre nasıl çalıştığını, effort seçiminin kalite ve maliyete etkisini anlatacağım. Ardından model policies ile kurumsal kontrolün ve faturayı okurken dikkat edeceğim sınırların üzerinde duracağım.
Model picker’da ne değişti?
GitHub’ın GA duyurusuna göre Fusion, VS Code, Copilot app, Copilot CLI ve JetBrains içinde kullanılabiliyor. Önceden auto veya HydraFusion kullananların seçimleri karşılık gelen Fusion effort seviyelerine taşınıyor. Bu geçişte ekip üyelerinin seçili ayarını yeniden kontrol edin. Herkes aynı effort ile devam etmeyebilir.
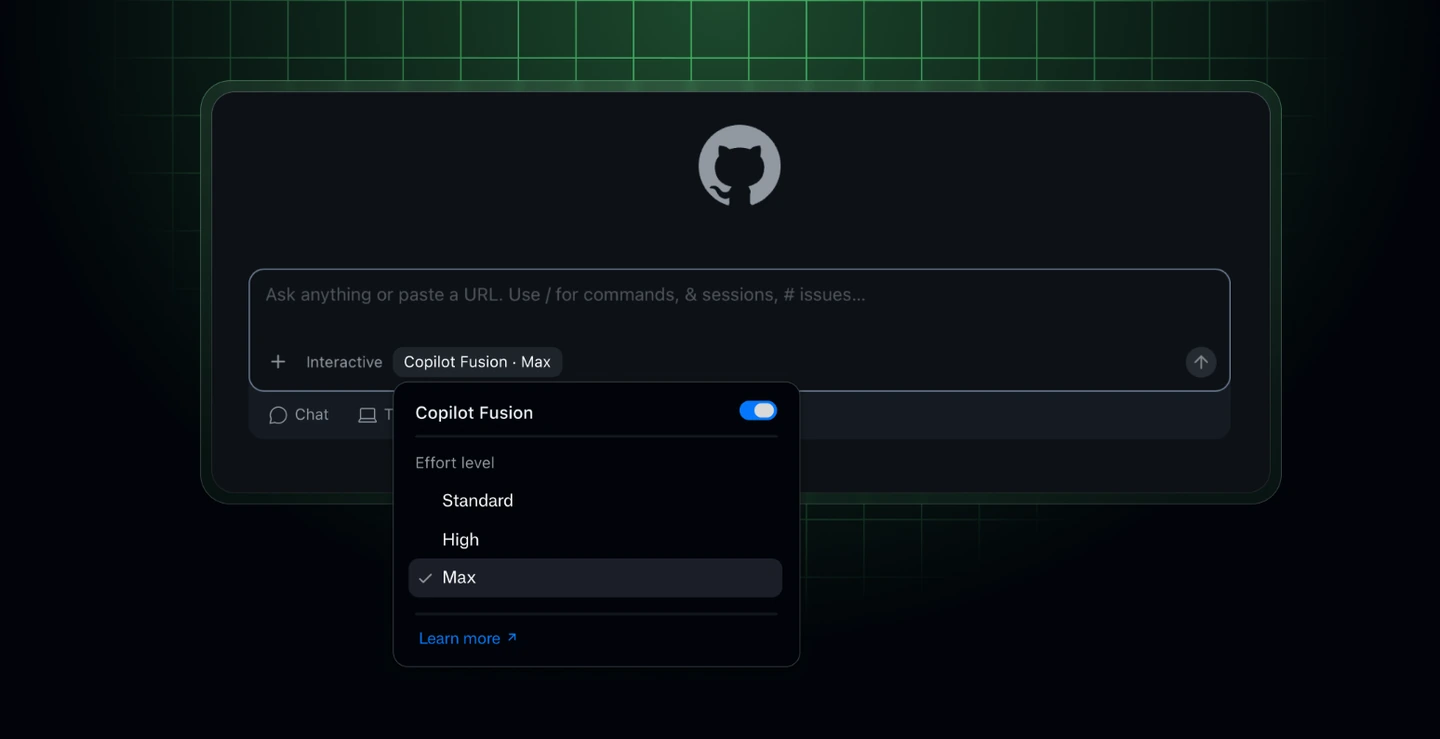
Fusion ayrı bir temel model ya da subagent değil. Görevin niteliğine göre model seçimini ve gerektiğinde modeller arasındaki çalışma sırasını yönetiyor. Belirli bir modeli kendiniz seçme imkanı da duruyor. Tek modelle çalışmak isteyen geliştiricinin elindeki seçim yerli yerinde.
Pratikte isteğin hangi modelle başlayacağına Fusion karar veriyor. Kısa bir açıklama isteği tek modelde biter, çok dosyaya yayılan bir değişiklikte ikinci model devreye girebilir. Bir isteğin kaç model çağrısı ürettiğini yanıttan değil, AI Credits tüketiminden görürsünüz; effort ve tüketimi izlemeden yalnızca sonuca bakmak yeterli olmaz.
Single, Cascade ve Critique nasıl ayrılıyor?
GitHub’ın Fusion açıklamasında Single günlük işlerde tek modelle ilerleyen akış. Fusion Standard bu yolu önceliklendiriyor. Örneğin küçük bir kod açıklamasında ikinci bir modelin değerlendirmesi her zaman gerekli olmayabilir. Tek model seçme devrinin bittiğini söylemek bu yüzden doğru gelmiyor bana.
Cascade, ekonomik modelle başlayıp ilk çıktının kontrolüne göre daha güçlü modele geçebiliyor. Critique’de ikinci model taslağı inceliyor, ilk model de gelen eleştiriye göre düzeltme yapıyor. Model picker’da sırayla basacağınız üç ayrı akış düğmesi aramayın, Fusion göreve göre yürütme akışını seçiyor.
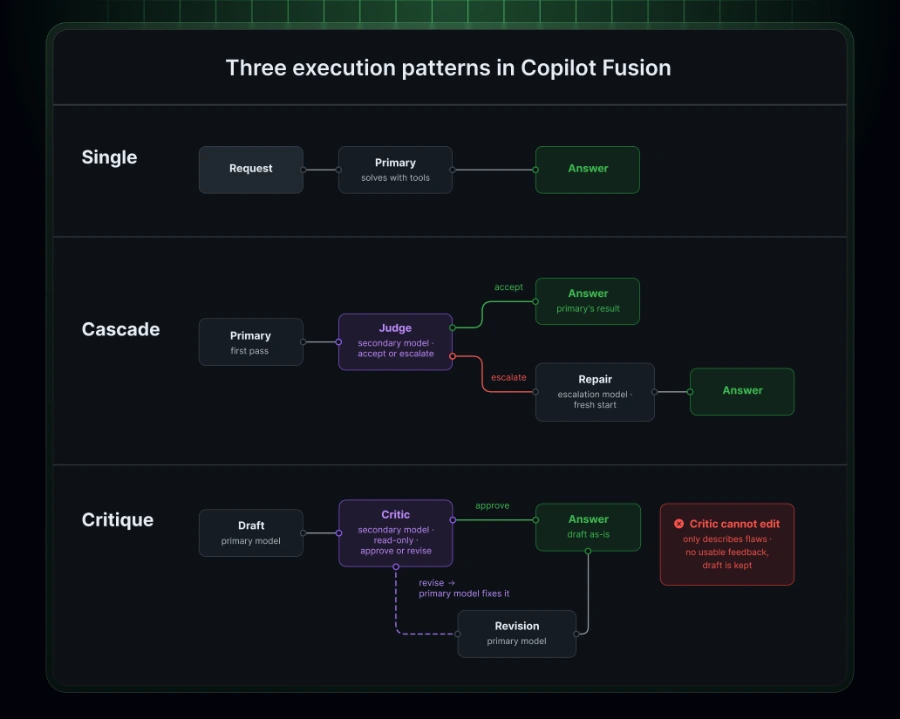
Fusion High ve Fusion Max ek model çağrılarına daha açık. Zor bir kodlama görevi için ikinci inceleme değerli olabilir, fakat her basit düzeltmede aynı yaklaşım faturaya yansır. Her işi ucuz olsun diye Standard’a bırakınca da zor görevde işe yarayabilecek ek kontrolü kaçırabilirsiniz. Kısa bir kod açıklamasıyla birden çok dosyaya yayılan değişikliği aynı effort düzeyinde değerlendirmem.
Bir küçük teknik ayrıntıyı atlamayın. Cascade sırasında terk edilen ilk taslak workspace’te dosya değiştirmişse Fusion o değişiklikleri otomatik geri almıyor. Commit öncesi diff’i ayrıca okuyun. Son yanıt temiz görünse bile dosyalarda önceki denemeden iz kalmış olabilir.
Yarı maliyet sözü faturada ne kadar geçerli?
GA duyurusundaki yaklaşık yarı maliyet ifadesini görünce ilk bakacağım şey karşılaştırmanın neyi ölçtüğü. GitHub, Artificial Analysis Coding Agent Index üzerinde Fusion Max’i Claude Code with Opus 5.5 Max ile görev başına ortalama API maliyeti açısından kıyaslıyor. Aynı açıklamada Fusion Max için 60 puan, yaklaşık yarı token tüketimi ve görev başına yaklaşık yüzde 40 daha kısa süre bildiriliyor. Bunlar her ekibin Copilot faturasının yarıya ineceği anlamına gelmiyor.
Resmi faturalandırma açıklaması, Fusion’ın kullandığı her model için o modelin standart tarifesi üzerinden AI Credits tükettiğini söylüyor. Ücretli planlarda 30 Kasım 2026’ya kadar model maliyetinde yüzde 30 indirim var. Bugünkü fiyatı kalıcı bütçe varsayımı olarak yazmayın. Model ve fiyat tablosunda bir AI Credit 0,01 ABD doları, tüketim ise kullanılan model ve token sayısına bağlı. Fusion tek istekte birden çok model çağırdığında her çağrı kendi tarifesiyle faturaya eklenir.
GitHub Copilot Business ve Enterprise kredi havuzu ile ek kullanım ayarlarını daha önce yazı hazırlarken çalıştım. O yüzden burada tek bir oturumun iyi sonucuna bakıp bütçe hükmü vermem. Benzer görevlerin seçilen effort seviyesini ve AI Credits tüketimini birlikte karşılaştırırım. Microsoft 365 Copilot’un kullanım bazlı faturalandırması üzerine yazımda da tüketimi önceden konuşmanın değerini anlatmıştım. Oradaki Copilot Credits ile buradaki GitHub AI Credits ayrı ürünlerin ölçüleri, ikisini tek sayaçta toplamaya kalkmayın.
Yönetici hangi modellere kapı açıyor?
Model policies, Fusion’ın seçebileceği modellerin sınırını çiziyor. GitHub’ın enterprise yönetim yönergesi hangi modellerin Fusion için kullanılacağını ayrı ayrı yönetmeyi anlatıyor. Kullanılabilir havuzdaki modellerin hiçbirine erişim yoksa Fusion model picker’da görünmüyor. Kullanıcı tarafında seçenek arayıp vakit kaybetmeden önce yönetici tarafını kontrol edin. Policy hangi modellerin çağrılabileceğini belirler, bir isteğin kaç kredi tüketeceğini belirlemez.
Bütçe politikaları üzerine daha önce çalışırken aklımı kurcalayan soru burada da iş görüyor. Ek kullanıma kim izin veriyor ve sınırı kim takip ediyor? Fusion’ın hangi modelleri çağırabileceği model policies ile belirlenir, ama High veya Max seçen ekibin harcaması kendi kendine bütçe hedefinize uymaz. Ben önce izin verilen model havuzunu gözden geçirir, ardından temsil gücü olan birkaç gerçek görevde Standard ile High sonuçlarını ve kredi tüketimini yan yana okurum. Max’i de zor görevlerde ayrı ölçerim, tek bir benchmark rakamı yerine kendi iş yükümün sonucuna bakarım.
Fusion’ı ekibe açarken cebimdeki kontrol listesi
- Model picker’da taşınan auto veya HydraFusion seçimini ve yeni effort seviyesini ekip üyeleriyle kontrol edin.
- Model policies içinde izin verilen modelleri, ek kullanım ayarlarını ve gerçek AI Credits tüketimini birlikte inceleyin.
- Zor görevleri High veya Max ile ölçün, commit öncesinde diff’i okuyun.
Benim ilk kurumsal denemem, indirim bitmeden farklı effort seviyelerini aynı tür gerçek işlerde ölçmek olur. Ekibinizde Fusion için hangi görevleri Standard’da, hangilerini High veya Max’te tutacağınızı yorumlarda konuşalım.